Martwe strefy w monitoringu nie zawsze wynikają z liczby kamer. Jak analizować geometrię obserwacji?
Dwanaście kamer może pilnować obiektu gorzej niż osiem. Problem pojawia się wtedy, gdy projektant liczy urządzenia, zamiast sprawdzać, co dokładnie każda kamera widzi, pod jakim kątem i z jaką gęstością pikseli. Na planie wszystko wygląda dobrze: stożki obserwacji nachodzą na siebie, wejście znajduje się w kadrze, parking jest „pokryty”. Dopiero nagranie z incydentu pokazuje, że twarz była widoczna głównie od góry, człowiek zniknął za zaparkowanym busem, a kamera mająca obejmować bramę rejestrowała samochód jako kilkudziesięciopikselową plamę.
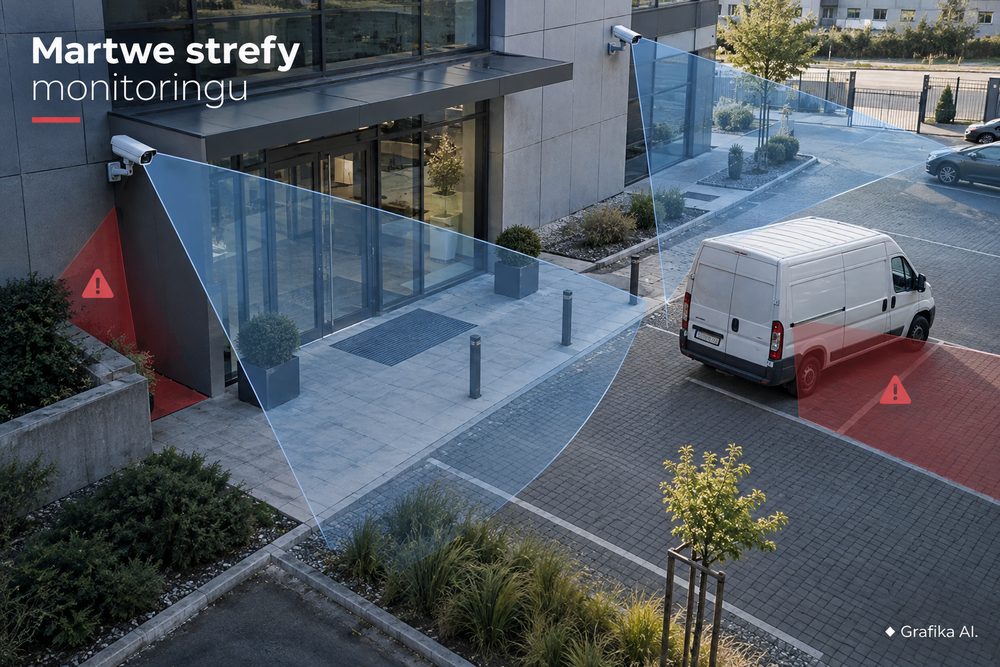
To właśnie jest jedna z najbardziej zdradliwych cech martwych stref w CCTV. Nie każda oznacza obszar całkowicie niewidoczny. Część z nich to strefy funkcjonalnie martwe: kamera rejestruje obraz, ale materiał nie pozwala wykonać zadania, dla którego system został zainstalowany.
Dlatego analizę monitoringu trzeba zaczynać nie od pytania „ile kamer potrzeba?”, lecz od trzech innych: co ma być rozpoznawalne, z jakiej odległości i na jakiej płaszczyźnie ma się znaleźć obiekt.
Martwa strefa zaczyna się od geometrii, a nie od braku kamery
Najprostsza martwa strefa znajduje się poza polem widzenia obiektywu. Tę łatwo zauważyć na rzucie budynku. Znacznie częściej problem występuje jednak wewnątrz teoretycznego pola widzenia.
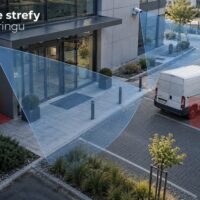
Typowy przykład to kamera zamontowana wysoko na elewacji. Na rzucie z góry jej stożek pokrywa chodnik od samej ściany aż po ogrodzenie. W rzeczywistości dolna krawędź obrazu może przecinać nawierzchnię kilka metrów od budynku. Pas bezpośrednio pod kamerą pozostaje niewidoczny.
Dla prostego modelu kamery można to policzyć. Jeżeli:
- kamera znajduje się na wysokości h,
- jej oś jest pochylona o α stopni poniżej poziomu,
- pionowy kąt widzenia wynosi VFoV, więc jego połowa to β = VFoV/2,
to przy płaskim terenie przybliżona odległość miejsca, w którym dolna krawędź obrazu przecina podłoże, wynosi:
d = h / tan(α + β).
Przykład: kamera jest na wysokości 4 m, pochylona o 30°, a jej pionowe pole widzenia wynosi 52°. Połowa kąta to 26°, więc:
d = 4 / tan(56°) ≈ 2,7 m.
Na rzucie kamera może wyglądać tak, jakby obserwowała przestrzeń „od ściany”. W praktyce pierwsze około 2,7 m nawierzchni pod nią nie znajduje się w kadrze. Człowiek oczywiście ma wysokość, więc jego głowa może pojawić się w obrazie wcześniej niż jego stopy, ale nadal nie oznacza to pełnej, użytecznej obserwacji.
Ten sam rachunek działa w drugą stronę. Górna krawędź obrazu przecina podłoże w odległości:
d = h / tan(α – β),
o ile α jest większe od β. W podanym przykładzie daje to około 57 m. Dopiero pomiędzy tymi granicami znajduje się fragment płaskiego podłoża obserwowany przez kamerę. Rzeczywisty obiekt ma oczywiście wysokość, teren może mieć spadek, a obiektyw wprowadza zniekształcenia, dlatego wynik jest punktem wyjścia do projektu, nie zamiennikiem pomiaru na obiekcie.
Drugi problem to przesłonięcia. Słup, filar, regał magazynowy, korona drzewa, wiata śmietnikowa czy zaparkowany dostawczak tworzą za sobą cień obserwacyjny. Na rzucie 2D kamera nadal „obejmuje” ten teren, ale promień widzenia kończy się na przeszkodzie.
Najgorszy układ powstaje wtedy, gdy dwie sąsiednie kamery patrzą na przeszkodę prawie z tej samej strony. Formalnie pola obserwacji się nakładają. Funkcjonalnie obie mają tę samą martwą strefę.
Dlatego przy projektowaniu trzeba sprawdzić osobno:
- przestrzeń bezpośrednio pod kamerą,
- narożniki budynków,
- obszary za słupami i filarami,
- przestrzeń między zaparkowanymi pojazdami,
- okolice bram i szlabanów,
- alejki pomiędzy regałami,
- strefy za drzewami i elementami małej architektury,
- miejsca, w których człowiek może zostać zasłonięty przez innego człowieka.
W praktyce dobre pokrycie nie oznacza więc, że dwa kolorowe stożki nachodzą na siebie w programie projektowym. Nakładanie ma być użyteczne: gdy jedna kamera traci obiekt za przeszkodą, druga powinna obserwować go z innej osi.
Szczególnie ostrożnie trzeba traktować kamery PTZ. Kamera obrotowa może patrolować duży teren, lecz w konkretnej sekundzie patrzy tylko w jednym kierunku. Jeżeli podczas zdarzenia obserwuje bramę wschodnią, pozostałe sektory są dla niej czasowo martwe. Jedna PTZ nie zastępuje kilku kamer stałopozycyjnych, gdy wymagane jest ciągłe pokrycie.
Szeroki kadr nie oznacza użytecznego obrazu. Trzeba policzyć piksele
Drugim częstym błędem jest traktowanie pola widzenia jako jedynego kryterium. Kamera obejmuje cały plac, więc projekt uznaje się za zakończony. Problem widać później: człowiek znajduje się w nagraniu, ale jego twarz zajmuje zbyt mało pikseli.
Podstawowy parametr to gęstość pikseli, zwykle wyrażana w px/m, czyli liczbie pikseli przypadających na metr szerokości obserwowanej sceny.
Najprostsze przybliżenie wygląda tak:
px/m = pozioma rozdzielczość obrazu / szerokość obserwowanej sceny w metrach.
Kamera 4 MP pracująca przykładowo w rozdzielczości 2688 × 1520 px daje:
- przy szerokości sceny 10 m – około 269 px/m,
- przy 15 m – około 179 px/m,
- przy 20 m – około 134 px/m,
- przy 25 m – około 108 px/m.
To pokazuje, dlaczego liczba megapikseli sama w sobie niewiele mówi. Ta sama kamera może dawać bardzo szczegółowy materiał na wejściu do budynku i tylko obraz orientacyjny na drugim końcu parkingu.
Przez lata do projektowania powszechnie wykorzystywano klasyczną skalę DORI związaną z wcześniejszą wersją IEC/EN 62676-4:
- Detect – 25 px/m,
- Observe – 62,5 px/m,
- Recognize – 125 px/m,
- Identify – 250 px/m.
Te wartości nadal można znaleźć w kartach katalogowych kamer i kalkulatorach producentów, dlatego są przydatnym językiem przy analizie istniejących instalacji. Nie należy jednak przedstawiać ich jako jedynej aktualnej skali normatywnej. IEC 62676-4:2025 przebudowała klasyfikację gęstości pikseli, wprowadzając poziomy 20, 40, 80, 125, 250, 500 i 1500 px/m.
W praktyce oznacza to jedno: projektując nowy system albo przygotowując dokumentację dla inwestora, trzeba sprawdzić, do której wersji normy odwołuje się specyfikacja, zamiast automatycznie kopiować tabelę DORI z kilkuletniego projektu.
Jeszcze ważniejsze jest to, że próg px/m nie gwarantuje dobrego materiału. Obraz o odpowiedniej rozdzielczości może nadal być bezużyteczny przez:
- zbyt stromy kąt obserwacji twarzy,
- ruch i zbyt długi czas ekspozycji,
- prześwietlenie od reflektorów,
- silne światło za obiektem,
- odbicie podczerwieni od ściany lub podsufitki,
- deszcz, mgłę albo zabrudzoną szybę obudowy,
- agresywną kompresję strumienia,
- błędnie ustawiony punkt ostrości.
Szczególnie dobrze widać to przy kamerach montowanych za wysoko. Załóżmy, że osoba znajduje się 4 m od ściany.
Kamera zawieszona na wysokości 6 m patrzy na twarz znajdującą się około 1,7 m nad ziemią przy różnicy wysokości 4,3 m. Kąt obserwacji w dół wynosi wtedy około:
arctan(4,3 / 4) ≈ 47°.
Jeżeli tę samą kamerę zamontujemy na wysokości 3 m, różnica wysokości do twarzy wynosi około 1,3 m, a kąt spada do:
arctan(1,3 / 4) ≈ 18°.
To dwie zupełnie różne perspektywy. Pierwsza dobrze pokazuje czubek głowy i ramiona. Druga daje znacznie korzystniejszy widok twarzy.
Nie oznacza to, że kamery należy zawsze montować nisko. Niska kamera jest bardziej narażona na zasłonięcie i wandalizm. Wysoka kamera lepiej pokazuje przebieg zdarzenia oraz położenie osób i pojazdów. W obiektach wymagających zarówno orientacji sytuacyjnej, jak i identyfikacji rozsądniejszy jest często podział zadań: jedna kamera daje szeroki obraz sytuacyjny, druga pilnuje punktu przejścia, wejścia albo bramy z węższym kadrem.
To samo dotyczy obiektywu. Krótsza ogniskowa zapewnia szerokie pole widzenia, ale rozciąga dostępną liczbę pikseli na większą część sceny. Dłuższa ogniskowa zawęża kadr i podnosi gęstość pikseli w interesującym obszarze.
Dlatego kamera 8 MP z bardzo szerokim obiektywem nie musi dawać lepszego materiału identyfikacyjnego niż kamera o niższej rozdzielczości skierowana na wąskie przejście. Megapiksele kupują potencjał. Geometria decyduje, gdzie ten potencjał zostanie wykorzystany.
Audyt geometrii trzeba zrobić na planie, a później powtórzyć w rzeczywistym obrazie
Najbardziej praktyczna metoda zaczyna się od podziału obiektu na zadania, nie na kamery.
Na planie trzeba zaznaczyć miejsca, w których system ma:
- wykryć obecność człowieka lub pojazdu,
- pozwolić śledzić kierunek przemieszczania,
- pokazać cechy osoby,
- dostarczyć odpowiednio szczegółowy obraz twarzy,
- odczytać tablicę rejestracyjną,
- pokazać konkretną czynność, np. pobranie towaru, wejście przez drzwi czy przekazanie przesyłki.
Dopiero później dobiera się punkty montażu.
Do prostego obiektu wystarczy rzut w skali i kalkulator pola widzenia. Przy parkingu wielopoziomowym, magazynie wysokiego składowania, hali produkcyjnej albo obiekcie z dużą liczbą przesłon zdecydowanie lepiej pracować na modelu 3D. Narzędzia takie jak IP Video System Design Tool firmy JVSG pozwalają analizować pola widzenia, gęstość pikseli i przesłonięcia na planie oraz w przestrzeni. W ekosystemie jednego producenta podobne zadania projektowe można wykonywać m.in. w AXIS Site Designer.
Program nie zwalnia jednak z wizji lokalnej. Model będzie tak dobry, jak dane, które do niego wprowadzono. Jeżeli na rzucie nie ma regału o wysokości 4,5 m, dostawczaka stojącego codziennie przy rampie albo sezonowo rozrastającej się korony drzewa, symulacja pokaże widoczność, której w rzeczywistości nie ma.
Praktyczny audyt istniejącego systemu można wykonać w następującej kolejności:
- najpierw zaznaczyć zadania obserwacyjne – wejścia, bramy, ciągi komunikacyjne, strefy kasowe, rampy, parking;
- zmierzyć rzeczywistą szerokość sceny w kluczowych odległościach;
- obliczyć px/m, zamiast opierać się na deklaracji „4 MP” czy „8 MP”;
- sprawdzić wysokość i pochylenie każdej kamery;
- nanieść przeszkody o rzeczywistej wysokości, nie tylko ich obrys na posadzce;
- przejść trasę człowieka przez obiekt i sprawdzić, czy można zachować ciągłość obserwacji;
- powtórzyć test samochodem, jeżeli system ma śledzić ruch pojazdów;
- obejrzeć zapis dzienny i nocny, bo geometria może być poprawna, a obraz nocny nadal nieużyteczny.
Ostatni punkt regularnie obnaża projekty wykonane wyłącznie na papierze. Kamera nocą przełącza się na podczerwień, a jasna ściana znajdująca się przy krawędzi obrazu odbija IR i wymusza zmianę ekspozycji. Środek parkingu robi się ciemny. Innym razem tablica rejestracyjna odbija światło tak mocno, że samochód jest widoczny, ale numer już nie.
Jest też prosty test, który warto wykonać po instalacji. Osoba testowa powinna przejść przez każdą krytyczną trasę: od granicy działki do wejścia, od parkingu do drzwi, od bramy do rampy. Materiał należy później obejrzeć z zapisu, a nie tylko na żywo. Jeśli w którymś fragmencie operator traci osobę, widzi wyłącznie jej głowę od góry albo musi zgadywać, czy na dwóch nagraniach jest ten sam człowiek, geometria wymaga poprawy.
Nie trzeba od razu dokładać kamery. Często wystarcza:
- zmiana punktu montażu o 1–2 m,
- zmniejszenie wysokości,
- zmiana pochylenia,
- zastosowanie innej ogniskowej,
- skierowanie jednej z dwóch sąsiednich kamer bardziej poprzecznie,
- wykorzystanie trybu korytarzowego w wąskim przejściu.
Dopiero jeżeli po takich zmianach nadal pozostaje obszar bez wymaganego poziomu obrazu, dodatkowa kamera jest uzasadniona. Dokładanie urządzenia bez wcześniejszego usunięcia błędu geometrycznego często kończy się tym, że dwie kamery produkują dwa równie słabe ujęcia.
FAQ – najczęstsze pytania o martwe strefy i geometrię CCTV
Czy większa liczba kamer automatycznie zmniejsza liczbę martwych stref?
Nie. Jeżeli kamery są ustawione z podobnej osi albo mają te same przeszkody w polu widzenia, można zwiększyć liczbę urządzeń bez usunięcia faktycznej martwej strefy.
Czy kamera 8 MP zawsze daje lepszą identyfikację niż 4 MP?
Nie. Liczy się gęstość pikseli na obserwowanym obiekcie. 8 MP rozłożone na bardzo szeroki plac może dawać mniej użyteczny szczegół niż 4 MP skierowane na węższe przejście.
Ile px/m potrzeba do identyfikacji osoby?
W klasycznym modelu DORI stosowano dla poziomu Identify wartość 250 px/m. Aktualna IEC 62676-4:2025 posługuje się przebudowaną skalą gęstości 20/40/80/125/250/500/1500 px/m. W projekcie trzeba więc sprawdzić wymaganą wersję normy oraz faktyczne zadanie kamery, a nie tylko dopasować wynik do starej tabeli.
Czy martwą strefą jest wyłącznie miejsce poza kadrem?
Nie. Funkcjonalnie martwa jest również strefa, w której obiekt znajduje się w obrazie, ale jest zasłonięty, zbyt mały, prześwietlony, rozmyty albo obserwowany pod kątem uniemożliwiającym wykonanie wymaganej czynności.
Czy kamera PTZ może zastąpić kilka kamer stałych?
Tylko wtedy, gdy zaakceptowane jest okresowe pozostawianie części terenu bez obserwacji. Kamera PTZ nie rejestruje jednocześnie wszystkich kierunków, w które może się obrócić.
Czy wystarczy sprawdzić projekt w programie do CCTV?
Nie. Symulacja powinna poprzedzać instalację, ale końcową weryfikację trzeba wykonać na rzeczywistym obrazie, w dzień i w nocy, z uwzględnieniem pojazdów, roślinności, regałów, świateł i innych przeszkód, których może nie być w modelu.
Co najczęściej psuje dobry projekt po montażu?
Zmiana wysokości lub miejsca instalacji „bo kabel wyszedł metr dalej”, skierowanie kamery szerzej niż w projekcie oraz nieuwzględnienie stałych przeszkód. Kilkanaście stopni różnicy w pochyleniu albo zmiana ogniskowej potrafią całkowicie zmienić obszar spełniający wymagane px/m.
Więcej informacji na: https://www.internec.pl
Jeżeli trzeba wskazać pierwszą rzecz do sprawdzenia, nie zaczynaj od dokupowania kamer. Weź plan obiektu, wybierz trzy najważniejsze punkty przejścia – na przykład bramę, wejście i trasę z parkingu – i dla każdego sprawdź rzeczywistą szerokość kadru, px/m, wysokość montażu, kąt obserwacji oraz przeszkody. Najpierw usuń kamerę, która teoretycznie „widzi wszystko”, ale nie dostarcza użytecznego szczegółu. To właśnie takie szerokie, źle ustawione ujęcia najczęściej tworzą martwe strefy, których nie widać w tabeli z liczbą kamer.